Claude агент архитектура Opus 5.5 Anthropic — это подход, где модель рассуждает и выбирает следующий шаг, а отдельный исполнитель работает с файлами, терминалом и внешними системами. Так агенту не приходится выдавать все права сразу: опасные действия можно ограничить, записать в журнал или отправить человеку на подтверждение.
Я, Арина Михална, вижу здесь не красивую инженерную метафору, а вполне бытовое правило: тот, кто придумал действие, не должен незаметно сам себе выдать разрешение на всё подряд. Иначе получаем очень умного стажёра с ключами от офиса, банковского кабинета и кнопкой «удалить прод».
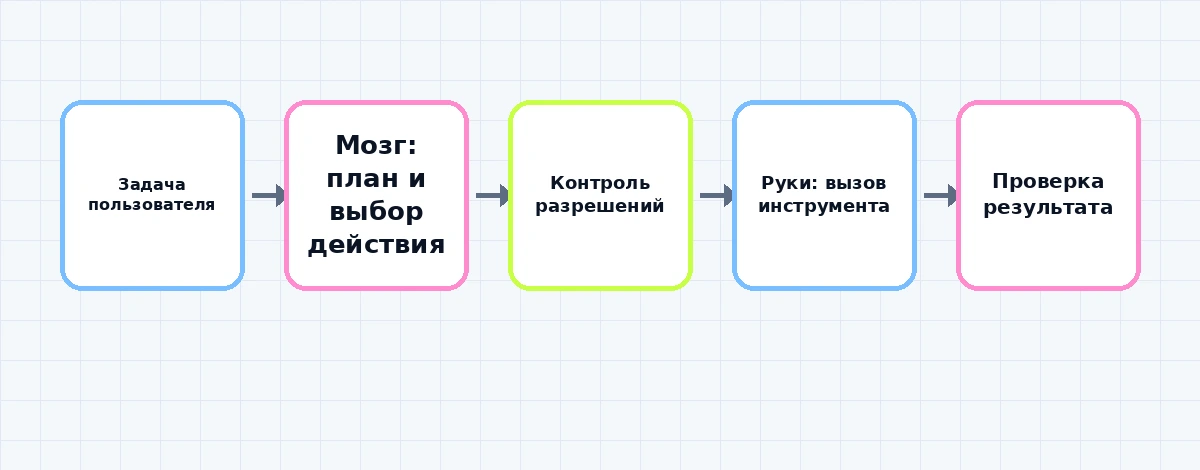
Что означает запрос «Claude агент архитектура Opus 5.5 Anthropic»
В материале Latent Space подход Anthropic описан формулой separating the brain from the hands, то есть «отделить мозг от рук». Важно не додумывать лишнего: это не обязательно две модели и не заявление, что внутри Claude сидят два независимых персонажа.
Речь про роли в агентной системе:
- мозг получает цель, читает контекст, строит план и выбирает следующее действие;
- руки принимают структурированную команду и обращаются к конкретному инструменту;
- контрольный слой решает, разрешено ли действие и нужно ли подтверждение человека;
- наблюдение возвращается модели, чтобы она оценила результат и продолжила работу.
Если совсем просто, модель может предложить: «Измени этот файл». Но доступ к файловой системе даёт не сама модель. Его выдаёт программа вокруг неё, причём только к нужной папке и только для разрешённых операций.
Это и есть разница между моделью и агентом. Модель отвечает. Агент отвечает, действует, смотрит на результат и делает следующий шаг. Если пока непонятна сама база, начни со статьи что такое ИИ-агент и из каких частей он состоит.
Как работают мозг, руки и контур обратной связи
Рабочий цикл агента можно уложить в пять шагов:
- Пользователь или система передаёт цель.
- Модель изучает доступный контекст и предлагает действие.
- Контрольный слой проверяет инструмент, параметры и права.
- Исполнитель запускает разрешённую операцию.
- Результат возвращается модели как новое наблюдение.
После пятого шага цикл повторяется. Агент либо выбирает следующий инструмент, либо сообщает, что задача завершена, либо останавливается из-за ошибки.
Здесь прячется важная деталь. «Руки» не должны понимать размытые человеческие пожелания. Им нужна конкретная команда: прочитать файл, выполнить тест, создать черновик письма, получить данные из API. Чем уже контракт инструмента, тем меньше пространства для сюрпризов.
| Слой | Что получает | Что возвращает | Чего не должен делать |
|---|---|---|---|
| Мозг | цель, контекст, результаты прошлых шагов | план или вызов инструмента | самовольно расширять права |
| Контроль | название инструмента и параметры | разрешение, отказ или запрос подтверждения | исполнять непроверенную команду |
| Руки | разрешённую структурированную операцию | результат, ошибку, код завершения | придумывать новую цель |
| Журнал | сведения о каждом шаге | историю для разбора | хранить секреты открытым текстом |
Сама модель может ошибиться в рассуждении. Инструмент может упасть. Внешний сервис может вернуть пустой ответ. Поэтому сообщение «готово» нельзя считать доказательством. Система должна проверить артефакт: файл существует, тест прошёл, запись действительно создана.
Если уже видно, что агент — это не один волшебный промпт, дальше нужна нормальная карта всей системы.
В канале «А.М. решает вопросы» я показываю, как раскладываю рабочие процессы на агентов, скиллы и проверки без технического тумана — .
забрать эти разборы и схемыПочему нельзя дать модели прямые «руки» без ограничений
Чем больше инструментов получает агент, тем больше становится зона ошибки. Проблема не только в злонамеренном поведении. Обычная неверная интерпретация задачи тоже может закончиться удалённым файлом, отправленным черновиком или испорченной базой.
Условно безопасный ответ в чате ничего не меняет снаружи. Ошибочный вызов инструмента уже меняет. Поэтому между мыслью модели и действием должен стоять программный барьер.
Вот четыре базовых предохранителя.
1. Минимальные права
Агент получает доступ только к тому, что нужно для текущей задачи. Если он сортирует документы в одной папке, ему не нужен весь диск. Если готовит письмо, ему не обязательно уметь отправлять его без подтверждения.
2. Список разрешённых инструментов
Исполнитель принимает только заранее описанные операции. Не «сделай что-нибудь в терминале», а конкретные команды с ограниченными параметрами.
3. Подтверждение необратимых действий
Удаление данных, публикация, отправка сообщений, изменение прав и любые денежные операции должны останавливаться перед исполнением. Человек видит, что именно собирается сделать агент, и принимает решение.
4. Журнал и проверка результата
Каждый вызов записывается: какой инструмент выбран, с какими параметрами, что вернулось. Секреты и персональные данные в журнал класть нельзя. После действия система отдельно проверяет результат, а не верит уверенной формулировке модели.
Anthropic выпустила открытую систему sandbox-runtime для изоляции агентов Claude Code. Смысл песочницы как раз в том, чтобы ограничить среду исполнения: агент работает не со всем компьютером, а внутри заданных границ.
Песочница при этом не чинит плохую архитектуру автоматически. Если ты разрешил опасный инструмент, передал ему секреты и не поставил подтверждение, само слово sandbox магическим щитом не станет.
Подробнее о границах и разрешениях я разбирала в статье как ограничить права ИИ-агента. Там фокус именно на том, что агенту можно доверить, а где рука человека пока обязательна.
Когда нужен один агент, а когда несколько исполнителей
Разделение мозга и рук не означает, что нужно сразу строить рой из десяти агентов. Часто хватает одной модели, одного цикла и нескольких узких инструментов.
Один агент подходит, если:
- задача имеет одну понятную цель;
- все шаги используют общий контекст;
- результат легко проверить;
- инструменты работают в одной зоне доступа;
- ошибка не требует сложного согласования между ролями.
Несколько агентов имеют смысл, когда части работы действительно независимы. Например, один собирает материалы, второй проверяет факты, третий приводит результат к формату. Но у такой схемы появляется цена: надо передавать контекст, разрешать конфликты и понимать, кто отвечает за финальный результат.
Я, Арина Михална, регулярно вижу одну и ту же собачью бегу: человек ещё не заставил одного агента стабильно создавать файл, но уже рисует «отдел» из двенадцати цифровых сотрудников. Красиво. Только чинить потом кого?
Если выбираешь между одиночной схемой и командой, держи простое правило: сначала один управляющий цикл с узкими руками. Разделяй систему только там, где можешь назвать независимую роль и отдельный критерий готовности.
Для сравнения вариантов пригодится мой разбор когда использовать одного Claude или команду агентов. А если нужны готовые архитектурные паттерны, смотри шесть архитектур для ИИ-агентов.
Как перенести подход Anthropic в своего агента
Не начинай с фреймворка. Сначала опиши контракт между мозгом и руками. Это можно сделать даже в обычном документе.
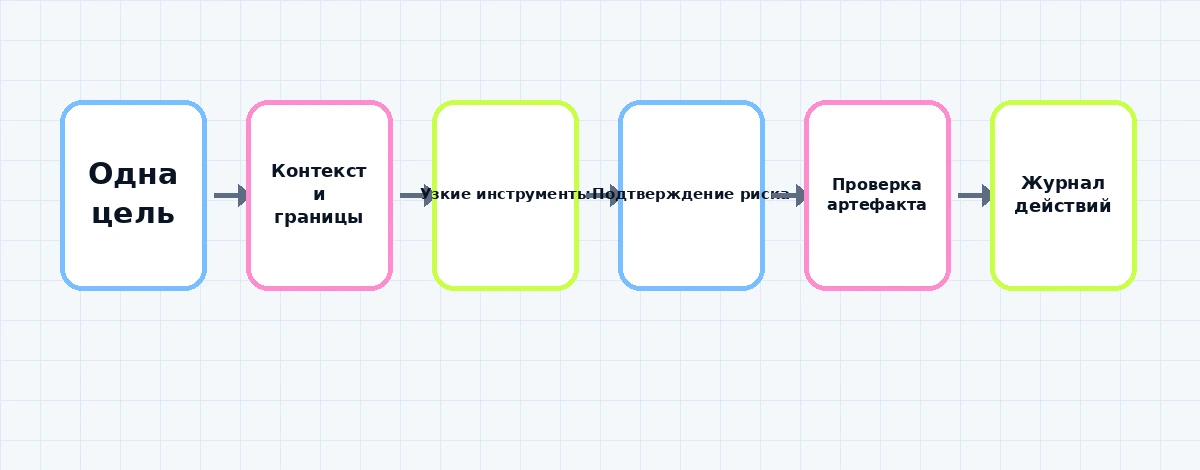
Заполни пять частей:
- Цель: какой один результат должен получить пользователь.
- Контекст: какие данные агент имеет право читать.
- Инструменты: какие конкретные действия разрешены.
- Стоп-сигналы: где нужно подтверждение человека.
- Проверка: как система понимает, что результат настоящий.
Вот шаблон, который можно отдать Claude перед проектированием агента:
Ты архитектор ИИ-агентов. Помоги спроектировать агента для задачи: {{опиши одну задачу}}.

Раздели систему на:
1. Мозг: какие решения принимает модель.
2. Руки: какие узкие инструменты ей нужны.
3. Контроль: какие параметры проверяются до запуска.
4. Подтверждение: какие действия нельзя выполнять без человека.
5. Проверка результата: какой артефакт или тест подтверждает готовность.
6. Журнал: что записывать после каждого действия без сохранения секретов.

Для каждого инструмента укажи:
- входные данные;
- разрешённую область работы;
- возможные ошибки;
- способ отката;
- условие остановки.

Не добавляй инструменты «на будущее». Если задачу можно решить одним агентом, не предлагай мультиагентную систему.
После ответа не иди сразу писать код. Возьми каждый инструмент и задай три неприятных вопроса:
- Что произойдёт, если параметры пустые или неверные?
- Может ли операция затронуть больше данных, чем нужно?
- Как вернуть состояние назад?
Если собираешь первый проект, отдельная инструкция как собрать агента на Claude поможет превратить эту схему в рабочую последовательность. А подключение внешних инструментов через MCP разобрано в материале что такое Claude MCP.
Где эта архитектура ломается
Самая частая поломка происходит не внутри модели, а на границе между решением и действием.
Слишком свободный инструмент. Функция принимает произвольную команду терминала вместо одной ограниченной операции. Модель получает лазейку, которую разработчик вроде бы не собирался давать.
Непроверенный результат. Инструмент вернул текст «успешно», и агент поверил. Файл при этом пустой, запись не создана или тест не запускался.
Скрытая смена цели. После нескольких шагов агент начинает исправлять соседние проблемы. Намерение может быть хорошим, но область задачи расползается.
Нет лимита цикла. Агент повторяет неудачное действие, тратит ресурсы и засоряет систему одинаковыми операциями.
Человек видит подтверждение без контекста. Кнопка «Разрешить» бесполезна, если рядом не показано, какой файл удаляется или куда уйдёт сообщение.
Поэтому хороший интерфейс подтверждения должен показывать действие человеческим языком: что изменится, где именно и можно ли отменить. Не просто название функции вроде execute_operation_7.
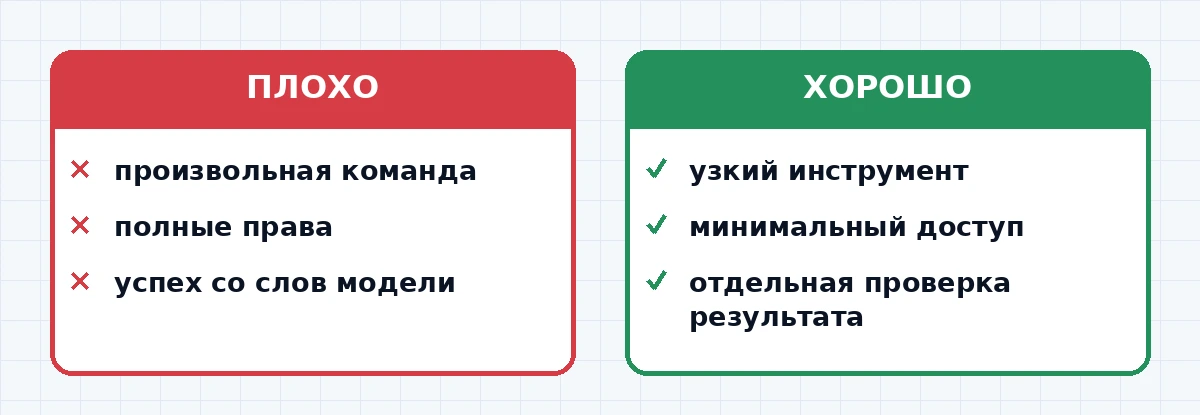
Разделение мозга и рук не делает агента безошибочным. Оно делает ошибки видимыми и управляемыми. Можно увидеть решение до исполнения, отклонить опасную операцию, ограничить ущерб и понять по журналу, где всё поехало.
И вот это уже взрослая агентная архитектура. Не «Claude, держи мой компьютер, удиви меня», а понятная система с правами, контрактами и тормозами.
По материалам: разбор Latent Space об архитектуре Anthropic, материал о sandbox-runtime Anthropic и официальная документация Claude Code.
Читайте также
- Архитектура ИИ агент паттерн LLM автоматизация: 6 схем в 2026
- Один агент вместо субагентов: Anthropic изменила рекомендации по архитектуре
- Claude Anthropic взломал GitHub-проект: как обезопасить агентов в 2026
- На портале «Мастерская нейросетей»: Нейросети архитектора: рендер за 15 минут
Теперь у тебя есть схема «мозг → контроль → руки → проверка», но живые агенты обычно ломаются на мелких решениях между этими блоками.
В Telegram-канале «А.М. решает вопросы» я разбираю такие сборки на реальных рабочих процессах: что отдавать Claude, где ставить человека и как не городить цифровой колхоз — .
забрать разборы Арины Михалны