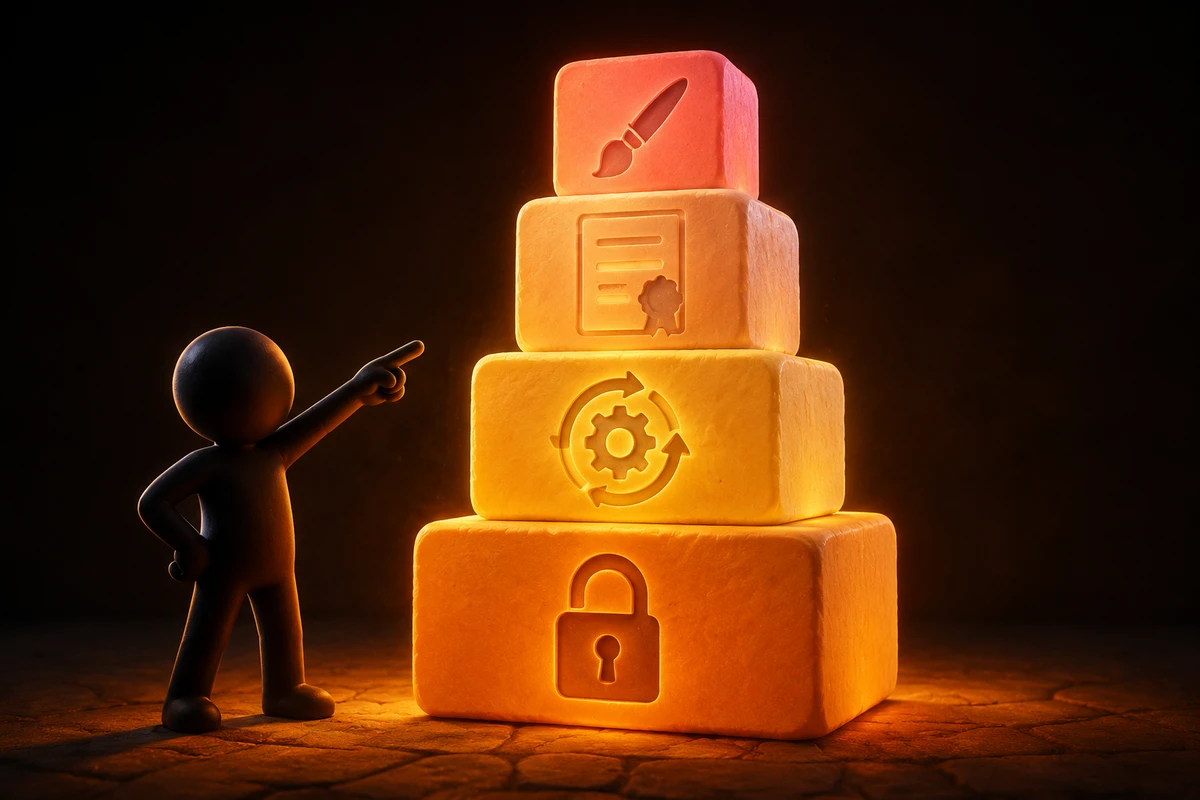
Меня зовут Арина Михална, и проверять код после AI-агента в 2026 году — это не построчная вычитка диффа, а работа по слоям риска: сначала права доступа и данные, потом миграции с репетицией отката, потом контракты API, потом тесты, и только в конце — стиль. Главный навык вайбкодинга — не ревью, а умение ставить агенту задачу такого размера, чтобы её вообще было можно проверить.
Почему построчное ревью кода агента — тупик
Simon Willison в разборе от 22 августа 2026 года пишет прямо: код-ревью после AI-агента — уже не то ревью, к которому все привыкли. Раньше ты вычитывал чужой код, потому что человек мог ошибиться в логике. Агент ошибается по-другому: он уверенно пишет рабочий на первый взгляд код, который тихо трогает не то, что нужно, — не потому что «не понял задачу», а потому что задача была слишком большой и расплывчатой.
Сама наступила на эти грабли в первый месяц вайбкодинга: дала агенту задачу «наведи порядок в обработке форм» — получила диф на 40 файлов, из которых вычитать построчно можно было часа три. Смысла в этом не было: я всё равно пропустила бы половину. С тех пор режу задачи так, чтобы диф помещался в один экран.
Проблема не в том, что агент плохо пишет код — он часто пишет его лучше, чем джуниор. Проблема в объёме: чем крупнее задача, тем больше в дифе мест, где надо было бы остановиться и подумать, а вычитывающий человек до них просто не долистывает.
Слой 1: права доступа и данные — проверяем первым
По разбору Simon Willison, самый недооценённый слой ревью — это не логика, а то, к чему код после AI-агента получает доступ. Агент может честно решить поставленную задачу и при этом расширить права там, где не просили: добавить лишний scope в токен, открыть эндпоинт без проверки авторизации, залогировать персональные данные в общий файл логов.
Это ровно тот слой, где ошибку тестами не поймаешь — тесты обычно проверяют «работает ли функция», а не «должна ли эта функция иметь доступ вот сюда». Смотреть нужно руками, и смотреть первым, потому что последствия здесь необратимы: утечка данных не откатывается git-ом.
Если у тебя уже есть свой скилл или агент, который автоматизирует часть проверок — почитай, что такое скиллы Claude и как их собирать под конкретную задачу, включая проверку прав.
Слой 2: миграции БД — репетиция отката, а не только «применилось»
Второй слой риска — миграции и фоновые задачи. Здесь у топ-выдачи по теме пробел: миграции упоминают вскользь, без техники. А техника простая: перед тем как принять миграцию, которую написал агент, прогоняешь её на копии продовой базы, а сразу после — откат. Если откат падает с ошибкой или теряет данные — миграцию переписываешь, даже если она красиво применилась вперёд.
Успешное «применилось» — это половина проверки. Откат — вторая половина, и её обычно пропускают, потому что она не входит в стандартный CI. Агент про откат сам не думает, если явно не попросить.
| Что проверяешь | Как | Что считается провалом |
|---|---|---|
| Миграция вперёд | Прогон на копии продовой БД | Ошибка выполнения, потеря индексов |
| Откат миграции | Тот же прогон, затем rollback | Rollback падает или удаляет данные без предупреждения |
| Фоновая задача | Запуск на тестовой очереди | Задача зависает или дублирует запись |
| Права после миграции | Ручная проверка grants/policy | Расширенные права без запроса |
Ты только прочитал, как проверять код по слоям риска — а собрать систему, которая ставит агенту задачи так, чтобы риск не возникал вообще, это отдельный навык.
На курсе «Claude за вечер» разбираем, как формулировать задачи агенту и выстраивать проверку с нуля — от 1490 ₽.
Забрать курс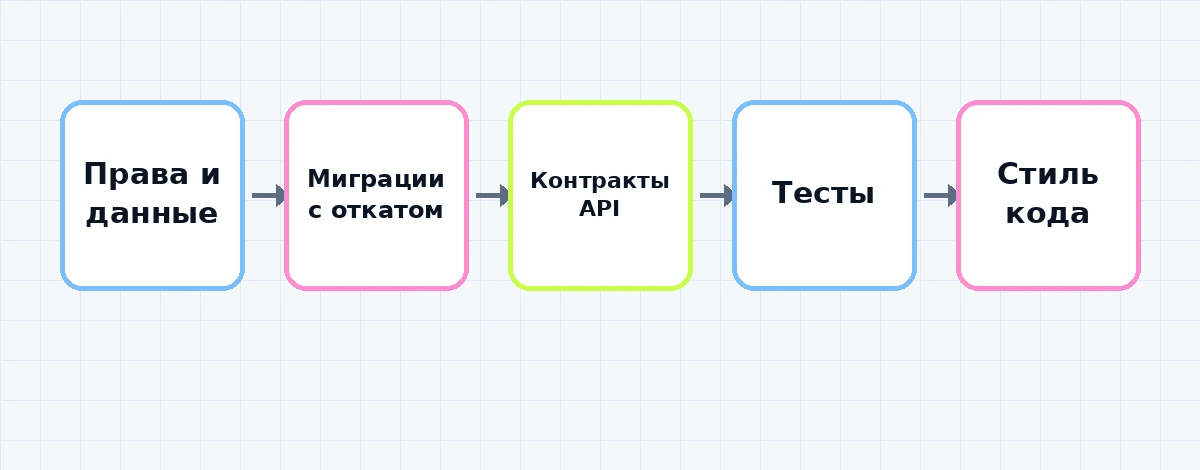
Слой 3: контракты API — тесты, которые агент не писал сам
Третий слой — границы: контракты API, сгенерированных агентом. Если агент написал и код, и тесты к нему, тесты подтверждают логику, которую агент сам придумал, а не то, что реально нужно потребителю API. Получается замкнутый круг: агент проверяет агента.
Рабочий приём — контрактные тесты со стороны потребителя: фиксируешь, какой именно ответ ожидает клиент (формат JSON, коды ошибок, обязательные поля), и эти тесты пишешь сам или берёшь из отдельного набора, не тронутого агентом на этой задаче. Если диф агента ломает контракт — тест падает независимо от того, что думает сам агент о своём коде.
Про то, как агенты вообще ведут себя в связке друг с другом и почему это усложняет ревью, — отдельная тема: как собрать своего первого агента на Claude разбирает базовую архитектуру, из которой видно, где закладывать такие проверки заранее.
Слой 4: тесты и покрытие — включая мутационные
Дальше — сам слой тестов. Здесь у топовой выдачи есть общее место: юнит-тесты, интеграционные, падающие тесты до правки. Но почти никто не пишет про то, что покрытие само по себе ничего не гарантирует — тесты, написанные тем же агентом под собственный код, могут формально покрывать строки и не ловить ни одной реальной регрессии.
Мутационное тестирование — техника, которая специально портит код небольшими правками и смотрит, ловят ли тесты эти правки. Если тест зелёный при испорченном коде — тест не тестирует ничего полезного, это просто balast для CI. Для AI-сгенерированного кода это особенно важно: агент умеет писать тесты, которые проходят, но не умеет сам себя честно проверить на «а если бы я тут ошибся».
Слой 5: стиль кода — последний, а не первый
Стиль, форматирование, именование переменных — то, на чём обычно начинают и заканчивают ревью нового человека в команде. С агентом это должен быть последний пункт, а не первый: линтер и автоформаттер решают стиль за секунды, и тратить на него внимание, пока не проверены права, миграции и контракты, — это как полировать капот у машины с неисправными тормозами.
Если тебе интересно, как в принципе устроена работа над проектами через Claude Code с самого начала — почитай про настройку проекта в Claude Code, там же про CLAUDE.md и структуру, которая упрощает весь цикл ревью выше.
Как ставить задачу агенту, чтобы её было можно проверить
Главный навык вайбкодинга, о котором пишет Simon Willison, — не ревью, а формулировка задачи. Чем точнее ограничен скоуп («поправь валидацию email в форме регистрации», а не «наведи порядок в формах»), тем меньше файлов в дифе и тем реальнее вычитать риск-слои за разумное время.
Ты работаешь с кодовой базой проекта {{название}}. Задача:
{{конкретное изменение}}.
Ограничения: трогать только файлы в папке {{путь}}, не
менять схему БД без явного
запроса, не добавлять новые зависимости. Если задача требует
изменений за пределами
этой папки — остановись и опиши, что нужно поменять и
почему, вместо того чтобы
делать это сразу.
Отдельная больная тема — параллельная работа нескольких агентов над одним проектом. Здесь у выдачи по запросу вообще нет техники ревью, только упоминание, что конфликты бывают. Рабочий подход: разбивай задачи так, чтобы агенты не пересекались по файлам, и ревьюй мёрж каждого агента отдельно — до того как их дифы встретятся друг с другом в одной ветке. Если пересечение неизбежно, один агент должен явно ждать завершения другого, а не работать вслепую с одним и тем же куском кода.
По материалам: разбора Simon Willison от 22 августа 2026 года о том, как меняется код-ревью в эпоху AI-агентов.
Про снос аккаунтов и другие грабли вайбкодинга я разбирала и в канале — если тема заходит, там больше живых примеров без сокращений под SEO.
Читайте также
- 80% разработчиков признались: зависимость от AI-кодинга — 2026
- Как ограничить ИИ-агента, чтобы он не хакнул сайт вместо вас: чек-лист безопасности
- Как собрать агента на Claude в 2026: пошаговый разбор архитектуры
- Claude MCP в 2026: что это и зачем нужен Claude Code
- На портале «Мастерская нейросетей»: Как создать AI-агентов для SMM и SEO в Claude Code
Меня зовут Арина Михална, и я знаю: систему проверки по слоям риска проще выстроить не в одиночку, а по готовой структуре. В боте у меня лежит гайд по установке и первым шагам с Claude — забрать его можно за подписку на канал, там же разборы реальных кейсов, где агент наделал дел и что с этим делать. Подписаться на канал